[대기업 사례] AI 학습 데이터를 바로 쓸 수 있는 상태로 공급하기까지
2026.10.20
불과 몇 년 전까지만 해도 AI 학습 데이터 이야기는 대부분 규모에서 시작했습니다. 몇억 개의 토큰을 모았는지, 몇 년치 데이터를 확보했는지가 곧 경쟁력처럼 이야기됐죠.
요즘 AI를 만드는 기업들이 데이터 공급사에 던지는 질문은 조금 달라졌어요. "얼마나 줄 수 있나요?"보다 "이걸로 학습한 모델을 어디까지 쓸 수 있나요?"를 먼저 묻습니다. 모델이 연구실을 벗어나 실제 제품과 서비스 안으로 들어가기 시작했기 때문입니다.
학습 데이터의 수명은 모델보다 깁니다
학습 데이터는 모델을 만드는 순간에만 쓰이고 끝나는 자산처럼 보입니다. 하지만 실제로는 그렇지 않아요.
한 번 학습한 모델은 다음 세대 모델의 기반이 되고, 하나의 서비스에서 시작해 여러 제품으로 퍼져 나갑니다. 그 과정에서 "이 데이터로 학습한 모델을 이 서비스에도 써도 되는가"라는 질문이 계속 생깁니다. 계약이 모델 개발 시점만 기준으로 짜여 있다면, 새 제품이 나올 때마다 권리를 다시 확인하고 협의해야 합니다.
결국 학습 데이터 계약의 수명은 데이터를 받는 날이 아니라, 그 모델이 마지막으로 쓰이는 날까지 이어진다고 보는 게 맞습니다.
학습 데이터 계약에서 달라진 세 가지
- 사용 목적이 잘게 나뉘었습니다.
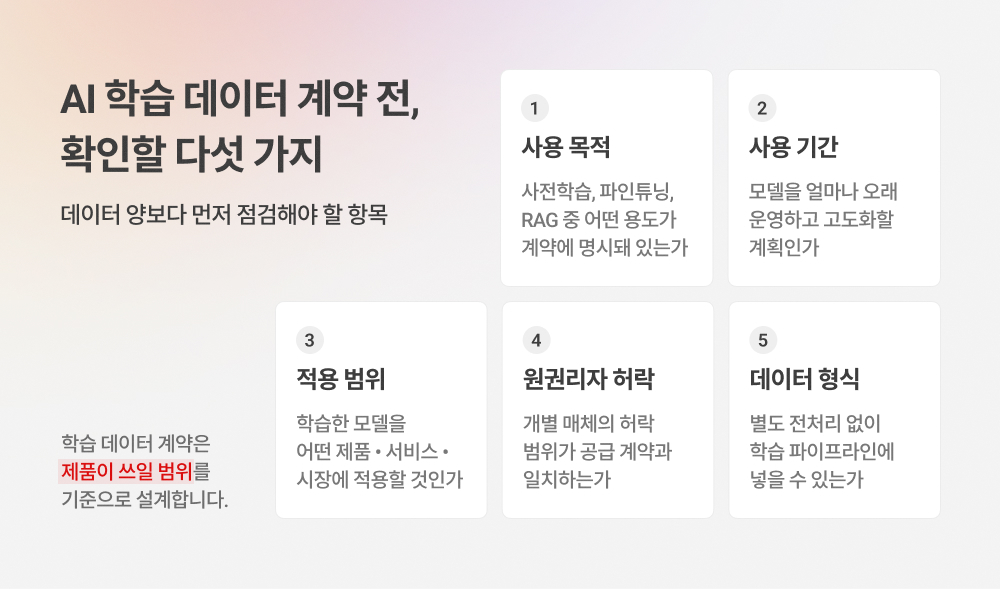
같은 데이터라도 사전학습, 파인튜닝, 실시간 검색 기반 답변(RAG)에 쓰는 것은 서로 다른 권리입니다. "AI에 쓴다"는 한 줄로는 부족하고, 어떤 방식으로 쓰는지가 계약에 적혀 있어야 해요. - 적용 범위가 넓어졌습니다.
하나의 모델이 여러 제품과 서비스, 때로는 여러 시장에 동시에 들어갑니다. 계약에 정한 범위가 실제 활용 계획보다 좁으면, 모델은 있어도 쓸 수 없는 곳이 생깁니다. - 원권리자 확인이 필수가 됐습니다.
뉴스는 개별 언론사의 저작물입니다. 공급사와 맺은 계약이 아무리 탄탄해도, 원권리자의 허락 범위와 맞지 않으면 그 계약은 흔들릴 수 있어요.
실제로는 이렇게 풀었습니다
비큐AI는 최근 한 국내 대기업에 자체 한국어 AI 모델의 사전학습용 뉴스 코퍼스를 공급했습니다. 이 기업은 학습한 모델을 여러 제품과 서비스로 확장할 계획이었고, 그래서 데이터 규모만큼이나 "어디까지 쓸 수 있는가"가 중요했습니다. 비큐AI는 AI 학습이라는 사용 목적을 계약에 명시하고, 사용 기간과 적용 범위를 고객사의 모델 활용 계획에 맞춰 설계했습니다. 각 언론사의 사용 허락도 별도로 확인했습니다. 덕분에 고객사는 새 제품에 모델을 올릴 때마다 데이터 권리를 다시 협의하지 않아도 되는 근거를 처음부터 갖추게 됐어요.
자세한 과제와 설계 과정은 RDPLINE 블로그의 활용 사례에서 확인하실 수 있습니다.
데이터 공급사의 역할도 달라지고 있습니다
이런 변화는 데이터 공급사가 하는 일도 바꿉니다. 예전에는 데이터를 많이, 깨끗하게 전달하는 것이 핵심이었다면, 이제는 그 데이터가 고객의 모델과 제품 안에서 어디까지 쓰일 수 있는지를 함께 설계하는 일이 더 중요해졌어요.
비큐AI는 한국언론진흥재단이 공식 지정한 저작권 유통사로서, 3,000여 개 매체와 맺은 정식 계약을 바탕으로 약 20년치 뉴스 데이터를 공급하고 있습니다. 그래서 데이터를 건네는 데서 끝나지 않고, 사용 목적과 기간, 적용 범위, 원권리자 확인까지 하나의 구조로 정리하는 일을 함께 하고 있습니다.
마치며
AI 모델의 경쟁력은 여전히 좋은 데이터에서 나옵니다. 다만 이제 "좋은 데이터"의 기준에는 품질과 규모뿐 아니라, 모델이 쓰일 모든 곳에서 문제없이 쓸 수 있는가도 포함됩니다.
AI 모델을 준비하고 있는데 학습 데이터의 사용 범위가 고민이시라면, 비큐AI와 함께 처음부터 정리해 보세요.